<?xml version="1.0" encoding="utf-8"?> <feed xmlns="http://www.w3.org/2005/Atom" xml:lang="en"> <generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator> <link href="https://allanvc.github.io/feed/R.xml" rel="self" type="application/atom+xml"/> <link href="https://allanvc.github.io/" rel="alternate" type="text/html" hreflang="en"/> <updated>2026-09-03T05:24:36+00:00</updated> <id>https://allanvc.github.io/feed/R.xml</id> <title type="html">Allan Quadros | R</title> <subtitle>My personal website </subtitle> <entry> <title type="html">‘mRpostman’ 1.4.0 is on CRAN</title> <link href="https://allanvc.github.io/blog/2026/mrpostman-1-4-0/" rel="alternate" type="text/html" title="‘mRpostman’ 1.4.0 is on CRAN"/> <published>2026-07-28T00:00:00+00:00</published> <updated>2026-07-28T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2026/mrpostman-1-4-0</id> <content type="html" xml:base="https://allanvc.github.io/blog/2026/mrpostman-1-4-0/"><![CDATA[<h2 id="mrpostman-140-is-on-cran">mRpostman 1.4.0 is on CRAN</h2> <p>A new version of my R package <strong>mRpostman</strong> landed on CRAN. It is the most important update to the package since I rebuilt it around an R6 object-oriented structure back in September 2020. This version incorporates several intermediate updates that were only available on GitHub in the previous weeks.</p> <h3 id="some-context">Some context</h3> <p>I released mRpostman in 2019, and of all the packages I have published, it was the one that caught the most attention from the R community (it even got a retweet from Hadley Wickham at the time). The reason is simple: e-mail is a rich source of data that usually sits out of reach, behind IMAP servers. mRpostman turns MIME content into plain text you can actually analyze.</p> <h3 id="what-is-new">What is new</h3> <p>The package now implements the full functionality of the IMAP4rev1 protocol from within R, including commands that were missing until recently, such as <code class="language-plaintext highlighter-rouge">APPEND</code>, <code class="language-plaintext highlighter-rouge">STATUS</code> and <code class="language-plaintext highlighter-rouge">CLOSE</code>, plus a set of capability-checked extensions such as <code class="language-plaintext highlighter-rouge">SORT</code>, <code class="language-plaintext highlighter-rouge">THREAD</code>, <code class="language-plaintext highlighter-rouge">MOVE</code> and <code class="language-plaintext highlighter-rouge">QUOTA</code>.</p> <p>Decoding grew up with it: message headers and bodies now honor the character set declared in the message, so mail in Russian, Greek, Japanese, Chinese or any other charset that <code class="language-plaintext highlighter-rouge">iconv</code> supports comes out as readable text instead of gibberish. Searching accepts non-ASCII terms as well, sent to the server as UTF-8.</p> <h3 id="reproducibility">Reproducibility</h3> <p>Reproducibility was another thing that bothered me all these years: you needed a real mail account to try any of it, and no two mailboxes are alike. This release fixes that. The package now ships a small disposable IMAP server (Dovecot, via Docker) plus a synthetic corpus generator with known properties: dates, sizes, encodings, attachments, reply chains. <code class="language-plaintext highlighter-rouge">populate_sandbox()</code> loads it all through the package’s own <code class="language-plaintext highlighter-rouge">APPEND</code> implementation, so you can test and learn every feature locally, against exact ground truth. There is a new vignette to help users with that.</p> <p>And since the sandbox can hold real data too, 1.4.0 adds <code class="language-plaintext highlighter-rouge">enron_sandbox()</code>, which downloads the public Enron corpus from 2001, filters by custodian and date, and ingests it into the local Dovecot server. From there, you can score sentiment over time, map who was writing to whom, or run whatever text mining you have in mind. Underneath it sits <code class="language-plaintext highlighter-rouge">ingest_maildir()</code>, a general function that uploads any maildir archive to any IMAP folder.</p> <div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">install.packages</span><span class="p">(</span><span class="s2">"mRpostman"</span><span class="p">)</span><span class="w">
</span></code></pre></div></div> <ul> <li>Official website: <a href="https://allanvc.github.io/mRpostman" target="_blank">https://allanvc.github.io/mRpostman</a></li> <li>Sandbox vignette: <a href="https://allanvc.github.io/mRpostman/articles/sandbox.html" target="_blank">https://allanvc.github.io/mRpostman/articles/sandbox.html</a></li> <li>CRAN version: <a href="https://cran.r-project.org/package=mRpostman" target="_blank">https://cran.r-project.org/package=mRpostman</a></li> <li>Dev version: <a href="https://github.com/allanvc/mRpostman" target="_blank">https://github.com/allanvc/mRpostman</a></li> </ul>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="mRpostman"/> <category term="IMAP"/> <category term="e-mail"/> <category term="text mining"/> <summary type="html"><![CDATA[mRpostman 1.4.0 is on CRAN]]></summary> </entry> <entry> <title type="html">‘treeSS’ - Tree-spatial scan statistics in R</title> <link href="https://allanvc.github.io/blog/2026/new-package-treess/" rel="alternate" type="text/html" title="‘treeSS’ - Tree-spatial scan statistics in R"/> <published>2026-07-15T00:00:00+00:00</published> <updated>2026-07-15T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2026/new-package-treess</id> <content type="html" xml:base="https://allanvc.github.io/blog/2026/new-package-treess/"><![CDATA[<h2 id="treess---tree-spatial-scan-statistics-in-r">treeSS - Tree-spatial scan statistics in R</h2> <p>I am happy to share <strong>treeSS</strong>, a new R package now available on CRAN.</p> <p>It helps you detect a special kind of cluster in your data: spatial clusters, meaning groups of nearby areas where something happens more often than expected. But it does one extra thing. It looks at <em>where</em> something happens (space) and <em>what kind</em> of thing happens (a category in a tree/hierarchy) at the same time. This is an advance over spatial-only or tree-only algorithms, and it does so without inflating the family-wise error rate.</p> <p>For example, you can use it to find which specific cause of death, type of crime, accident, or condition is unusually common in a group of nearby areas.</p> <p>The method, called the tree-spatial scan statistic, comes from our paper:</p> <blockquote> <p>Cançado, A. L. F., Oliveira, G. S., Quadros, A. V. C., &amp; Duczmal, L. H. (2025). A tree-spatial scan statistic. <em>Environmental and Ecological Statistics</em>, 32(3), 953-978. <a href="https://doi.org/10.1007/s10651-025-00670-w" target="_blank">https://doi.org/10.1007/s10651-025-00670-w</a></p> </blockquote> <p>Try it in R:</p> <div class="language-r highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">install.packages</span><span class="p">(</span><span class="s2">"treeSS"</span><span class="p">)</span><span class="w">
</span></code></pre></div></div> <p>A Python version is coming soon to PyPI.</p> <ul> <li>CRAN version: <a href="https://cran.r-project.org/package=treeSS" target="_blank">https://cran.r-project.org/package=treeSS</a></li> <li>Dev version: <a href="https://github.com/allanvc/treeSS" target="_blank">https://github.com/allanvc/treeSS</a></li> <li>Article: <a href="https://doi.org/10.1007/s10651-025-00670-w" target="_blank">https://doi.org/10.1007/s10651-025-00670-w</a></li> </ul>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="treeSS"/> <category term="spatial statistics"/> <category term="scan statistics"/> <category term="cluster detection"/> <summary type="html"><![CDATA[treeSS - Tree-spatial scan statistics in R]]></summary> </entry> <entry> <title type="html">‘mRpostman: An IMAP Client for R’ published in the Journal of Open Research Software</title> <link href="https://allanvc.github.io/blog/2024/mrpostman-journal-of-open-research-software/" rel="alternate" type="text/html" title="‘mRpostman: An IMAP Client for R’ published in the Journal of Open Research Software"/> <published>2024-03-21T00:00:00+00:00</published> <updated>2024-03-21T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2024/mrpostman-journal-of-open-research-software</id> <content type="html" xml:base="https://allanvc.github.io/blog/2024/mrpostman-journal-of-open-research-software/"><![CDATA[<h2 id="mrpostman-an-imap-client-for-r---journal-of-open-research-software">mRpostman: An IMAP Client for R - Journal of Open Research Software</h2> <p>I am excited to announce the publication of my recent paper in the <em>Journal of Open Research Software</em>, titled “mRpostman: An IMAP Client for R”. This work introduces a package designed to facilitate the retrieval of email data directly within R.</p> <center> <img alt="mRpostman paper in the Journal of Open Research Software" style="max-width: 100%; width: 420px;" src="https://allanvc.github.io/assets/img/publication_preview/JORS1.png"/> </center> <blockquote> <p>Quadros, A. V. C. (2024). mRpostman: An IMAP Client for R. <em>Journal of Open Research Software</em>, 12(1). <a href="https://doi.org/10.5334/jors.480" target="_blank">https://doi.org/10.5334/jors.480</a></p> </blockquote> <p>I acknowledge my potential bias, but I believe mRpostman stands out for its user-friendly interface and implementation using an elegant object-oriented (OO) approach.</p> <p>Here are some of the applications in which mRpostman can be particularly helpful:</p> <p><strong>Email content analysis.</strong> With mRpostman, researchers and analysts can dive deep into email content to uncover trends, patterns, and themes. This capability is invaluable in organizational contexts, enabling a deeper understanding of communication flows, for example. The package is the first step for advanced text mining techniques for sentiment analysis, keyword discovery, and thematic exploration using email data.</p> <p><strong>Attachment analysis.</strong> mRpostman simplifies the process of downloading and analyzing email attachments. Whether it is automating attachment fetching, extracting text from PDFs, scrutinizing images, or leveraging spreadsheet data in R for comprehensive statistical analysis, mRpostman provides the necessary functionality to expand the analysis beyond the email text.</p> <p><strong>Network analysis.</strong> By leveraging email metadata, such as sender, recipient, and CC details, mRpostman facilitates the construction of intricate communication networks. This opens the door to sophisticated social network analysis, offering insights into the dynamics of communication within organizations or social groups.</p> <p><strong>Spam detection and filtering.</strong> mRpostman serves as a foundational tool for developing advanced spam detection algorithms. By enabling easy access to extensive email datasets, it aids in training machine learning models to distinguish between spam and legitimate messages efficiently.</p> <p><strong>Time series analysis.</strong> Using the temporal data available in email metadata, mRpostman enables users to perform time series analysis. This can reveal communication patterns, peak activity times, and email flow trends, offering valuable insights into organizational or group communication behaviors.</p> <ul> <li>Article: <a href="https://doi.org/10.5334/jors.480" target="_blank">https://doi.org/10.5334/jors.480</a></li> <li>Official website: <a href="https://allanvc.github.io/mRpostman" target="_blank">https://allanvc.github.io/mRpostman</a></li> <li>CRAN version: <a href="https://cran.r-project.org/package=mRpostman" target="_blank">https://cran.r-project.org/package=mRpostman</a></li> </ul>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="mRpostman"/> <category term="IMAP"/> <category term="e-mail"/> <category term="publication"/> <summary type="html"><![CDATA[mRpostman: An IMAP Client for R - Journal of Open Research Software]]></summary> </entry> <entry> <title type="html">ROC App: an application to understand ROC curves - new paper in the Brazilian Journal of Biometrics</title> <link href="https://allanvc.github.io/blog/2022/roc-app-brazilian-journal-of-biometrics/" rel="alternate" type="text/html" title="ROC App: an application to understand ROC curves - new paper in the Brazilian Journal of Biometrics"/> <published>2022-06-13T00:00:00+00:00</published> <updated>2022-06-13T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2022/roc-app-brazilian-journal-of-biometrics</id> <content type="html" xml:base="https://allanvc.github.io/blog/2022/roc-app-brazilian-journal-of-biometrics/"><![CDATA[<h2 id="roc-app-an-application-to-understand-roc-curves">ROC App: an application to understand ROC curves</h2> <p>Our paper “ROC App: an application to understand ROC curves”, with Georges von Borries (University of Brasilia), was published in the <em>Brazilian Journal of Biometrics</em>.</p> <center> <img alt="ROC App paper in the Brazilian Journal of Biometrics" style="max-width: 100%; width: 420px;" src="https://allanvc.github.io/assets/img/publication_preview/BJB.png"/> </center> <blockquote> <p>von Borries, G. F., &amp; Quadros, A. V. C. (2022). ROC App: an application to understand ROC curves. <em>Brazilian Journal of Biometrics</em>, 40(2). <a href="https://doi.org/10.28951/bjb.v40i2.566" target="_blank">https://doi.org/10.28951/bjb.v40i2.566</a></p> </blockquote> <h3 id="what-the-paper-is-about">What the paper is about</h3> <p>The Receiver Operating Characteristic (ROC) curve is one of those concepts that every student of statistics, data science or medicine meets early on, and that many keep finding confusing: what exactly moves along the curve, how it relates to sensitivity and specificity, and why a threshold that looks good for one population is bad for another.</p> <p>The ROC App is a Shiny application built to make these ideas concrete. Using a diagnostic test as the motivating scenario, the user controls the parameters of the healthy and diseased populations (their means, variances and the cutoff of the test) and watches, in real time, how the ROC curve and the accuracy rates (sensitivity, specificity, false positive and false negative rates) respond to each change. The paper describes the underlying concepts, the app’s functionalities and how it can be used in the classroom.</p> <p>The app is freely available online and runs in the browser, so it can be used in class without any installation.</p> <h3 id="abstract">Abstract</h3> <p>We present a software application to help students understand the Receiver Operating Characteristic (ROC) curve and other concepts associated with binary classification models. We use the diagnostic test scenario as a motivation to explain the underlying concepts and the app functionalities. The ROC App enables students to interactively learn why/how the ROC curve closely relates to the accuracy rates, by seeing how these curves and rates respond to modifications on the population’s parameters.</p> <ul> <li>ROC App: <a href="https://gfvonborries.shinyapps.io/roc_app/" target="_blank">https://gfvonborries.shinyapps.io/roc_app/</a></li> <li>Article: <a href="https://doi.org/10.28951/bjb.v40i2.566" target="_blank">https://doi.org/10.28951/bjb.v40i2.566</a></li> <li>Full list of publications: <a href="https://allanvc.github.io/publications/">/publications/</a></li> </ul>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="ROC curve"/> <category term="shiny"/> <category term="teaching"/> <category term="publication"/> <summary type="html"><![CDATA[ROC App: an application to understand ROC curves]]></summary> </entry> <entry> <title type="html">‘mRpostman’ - IMAP Tools for R in a Tidy Way</title> <link href="https://allanvc.github.io/blog/2019/new-package-mrpostman/" rel="alternate" type="text/html" title="‘mRpostman’ - IMAP Tools for R in a Tidy Way"/> <published>2019-08-22T00:00:00+00:00</published> <updated>2019-08-22T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2019/new-package-mrpostman</id> <content type="html" xml:base="https://allanvc.github.io/blog/2019/new-package-mrpostman/"><![CDATA[<h2 id="mrpostman---imap-tools-for-r-in-a-tidy-way">mRpostman - IMAP Tools for R in a Tidy Way</h2> <center> <img alt="hexlogo" width="200" src="./img/mRpostman.png"/> </center> <p><strong>mRpostman</strong> is an <strong>R</strong> package to help you to easy connect to your IMAP (Internet Message Access Protocol) server and execute commands, such as listing mailboxes, fetching and searching for messages in a tidy way. It heavily relies on {curl} for issuing the IMAP commands.</p> <p>So far, <code class="language-plaintext highlighter-rouge">mRpostman</code> have been tested with Gmail, Yahoo Mail and AOL Mail, but it should also work with other mail providers. I would be happy to hear other successful experiences from users.</p> <p>ATTENTION: Before you start, you have to enable <strong>“less secure apps access”</strong> in your mail account settings.</p> <p>There is a detailed vignette <a href="https://allanvc.github.io/mRpostman/articles/basics.html">HERE</a> showing how to use the package!</p> <p>That’s all!</p> <ul> <li>Official website: https://allanvc.github.io/mRpostman</li> <li>CRAN version: https://cran.r-project.org/package=mRpostman</li> <li>Dev version: https://github.com/allanvc/mRpostman</li> </ul>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="mRpostman"/> <category term="IMAP"/> <category term="e-mail"/> <summary type="html"><![CDATA[mRpostman - IMAP Tools for R in a Tidy Way]]></summary> </entry> <entry> <title type="html">Announcing the new ‘emstreeR’ package</title> <link href="https://allanvc.github.io/blog/2018/new-package-emstreer/" rel="alternate" type="text/html" title="Announcing the new ‘emstreeR’ package"/> <published>2018-12-10T00:00:00+00:00</published> <updated>2018-12-10T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2018/new-package-emstreer</id> <content type="html" xml:base="https://allanvc.github.io/blog/2018/new-package-emstreer/"><![CDATA[<h2 id="announcing-the-new-emstreer-package-2020s-ggmap-update">Announcing the new ‘emstreeR’ package (2020’s {ggmap} update)</h2> <hr/> <p>I am proud to announce <strong>emstreeR</strong> - my first <strong>R</strong> package available on CRAN.</p> <p><strong>emstreeR</strong> is a package for fast and easily computing Euclidean Minimum Spanning Trees (EMST). It heavily relies on RcppMLPACK and Rcpp to work as wrapper to the EMST Dual-Tree Boruvka algorithm (March, Ram, Gray, 2010)^[March, W. B., and Ram, P., and Gray, A. G. (2010). <em>Fast euclidean minimum spanning tree: algorithm analysis, and applications</em>. 16th ACM SIGKDD International Conference on Knowledge Discovery and Data mining, July 25-28 2010. Washington, DC, USA. <a href="https://doi.org/10.1145/1835804.1835882">doi:10.1145/1835804.1835882</a>.] implemented in ‘mlpack’ - the C++ Machine Learning library (Curtin et al., 2013)^[Curtin, R. R. et al. (2013). Mlpack: A scalable C++ machine learning library. <em>Journal of Machine Learning Research</em>, v. 14, 2013.]. With <code class="language-plaintext highlighter-rouge">emstreeR</code>, R users have access to the C++ fast EMST algorithm without having to deal with the R-Rcpp-C++ integration. The package also provides functions and an S3 method for readily plotting the Minimum Spanning Trees (MST) using either {base}, {scatterplot3d} or {ggplot2} style.</p> <p>Working with <code class="language-plaintext highlighter-rouge">emstreeR</code> is easy because you just have to pass a matrix or data.frame of points as an argument to the main function <code class="language-plaintext highlighter-rouge">computeMST()</code> in order to get things working.</p> <hr/> <p>But, before we begin, what exactly is a Minimum Spanning Tree?</p> <p>I will try to explain that without bringing any graph concept to the discussion.</p> <p>Imagine you have to connect a group of South American cities with pipelines in order to distribute the natural gas extracted from an offshore platform on the coast of Rio de Janeiro. To optimize your operations, you need to know the most efficient route, i.e. the route that connects all the cities within the minimum possible distance. That optimal route among the cities is a Minimum Spanning Tree. Therefore, the MST problem is, in its essence, an optimization problem.</p> <p>The distances between two points can be calculated using various methods, such as Manhattan, Euclidean, Minkowski, etc. This package uses Euclidean distances. Hence, the name Euclidean Minimum Spanning Trees.</p> <p>So, let’s try to reproduce the aforementioned example.</p> <p>First, we are going to use the {ggmap} package . We will pass the cities names as arguments to <code class="language-plaintext highlighter-rouge">ggmap::geocode()</code> function in order to get their latitude and longitude coordinates. For this, we need the <em>Geocoding Google API</em>. For more instructions on how to enable the API and how to obtain a API key, please refer to the documentation of the <code class="language-plaintext highlighter-rouge">ggmap::register_goole()</code> function.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">library</span><span class="p">(</span><span class="n">ggmap</span><span class="p">)</span><span class="w">

</span><span class="c1">## cities:</span><span class="w">
</span><span class="n">cities_location</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">data.frame</span><span class="p">(</span><span class="n">location</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="s2">"Passo Fundo, Brazil"</span><span class="p">,</span><span class="w"> 
                                           </span><span class="s2">"Buenos Aires, Argentina"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Assuncion, Paraguay"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Campinas, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Cubatao, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Mendoza, Argentina"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Corrientes, Argentina"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Porto Velho, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Manaus, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Santa Cruz de La Sierra, Bolivia"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Belo Horizonte, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Brasília, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Rio de Janeiro, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Campo Grande, Brazil"</span><span class="p">,</span><span class="w">
                                           </span><span class="s2">"Recife, Brazil"</span><span class="p">),</span><span class="w"> 
                              </span><span class="n">stringsAsFactors</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="kc">FALSE</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Warning in readLines(con &lt;- file("../../../API_key.txt")): cannot open file
## '../../../API_key.txt': No such file or directory</code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error in `readLines()`:
## ! cannot open the connection</code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error:
## ! object 'API_key' not found</code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## register your Google API</span><span class="w">
</span><span class="n">register_google</span><span class="p">(</span><span class="n">key</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">rstudio</span><span class="o">::</span><span class="s2">"AIza...8RLaPBOQ"</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## get latitude and longitude</span><span class="w">
</span><span class="n">geo_location</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">geocode</span><span class="p">(</span><span class="n">cities_location</span><span class="o">$</span><span class="n">location</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error in `geocode()`:
## ! Google now requires an API key; see `ggmap::register_google()`.</code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## combine data:</span><span class="w">
</span><span class="n">df_location</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">cbind</span><span class="p">(</span><span class="n">cities_location</span><span class="p">,</span><span class="w"> </span><span class="n">geo_location</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error:
## ! object 'geo_location' not found</code></pre></figure> <p>Let’s plot the map, so we can have an initial idea about what we are dealing with.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># coordinates for South America</span><span class="w">
</span><span class="n">map_grid</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="n">left</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">-80</span><span class="p">,</span><span class="w"> </span><span class="n">bottom</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">-40</span><span class="p">,</span><span class="w"> </span><span class="n">right</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">-20</span><span class="p">,</span><span class="w"> </span><span class="n">top</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">0</span><span class="p">)</span><span class="w"> 

</span><span class="n">library</span><span class="p">(</span><span class="n">dplyr</span><span class="p">)</span><span class="w"> </span><span class="c1"># we wanna use pipes</span><span class="w">

</span><span class="n">get_stamenmap</span><span class="p">(</span><span class="n">map_grid</span><span class="p">,</span><span class="w"> </span><span class="n">zoom</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">5</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w"> </span><span class="n">ggmap</span><span class="p">()</span><span class="o">+</span><span class="w">
  </span><span class="n">geom_point</span><span class="p">(</span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">df_location</span><span class="p">,</span><span class="w">
           </span><span class="n">aes</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lon</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lat</span><span class="p">),</span><span class="w"> </span><span class="n">size</span><span class="o">=</span><span class="m">2</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error in `get_stamenmap()`:
## ! Stamen map tiles are now hosted by Stadia Maps, use `get_stadiamap()`.</code></pre></figure> <p>Now is when <code class="language-plaintext highlighter-rouge">emstreeR</code> comes in handy. We pass the point columns as argument to <code class="language-plaintext highlighter-rouge">computeMST()</code> and it calculates the minimum route connecting all the points, i.e. the Euclidean Minimum Spanning Tree.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## MST:</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">emstreeR</span><span class="p">)</span><span class="w">
</span><span class="n">out</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">ComputeMST</span><span class="p">(</span><span class="n">df_location</span><span class="p">[,</span><span class="m">2</span><span class="o">:</span><span class="m">3</span><span class="p">])</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error:
## ! object 'df_location' not found</code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">out</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error:
## ! object 'out' not found</code></pre></figure> <p>As a result, we have a data.frame containing our original data and three more columns: <code class="language-plaintext highlighter-rouge">from</code>, <code class="language-plaintext highlighter-rouge">to</code>, and <code class="language-plaintext highlighter-rouge">distance</code>. This information is the Minimum Spanning Tree and will be used for plotting.</p> <p>You can silence the output of the algorithm by setting <code class="language-plaintext highlighter-rouge">verbose=FALSE</code> in <code class="language-plaintext highlighter-rouge">computeMST()</code>.</p> <p>To better visualize the result, we plot the map again, but now using the {ggplot2}’s extension provided in <code class="language-plaintext highlighter-rouge">emstreeR</code>: <code class="language-plaintext highlighter-rouge">stat_MST()</code>.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## Plot:</span><span class="w">
</span><span class="c1"># we use the same grid map    </span><span class="w">
</span><span class="n">get_stamenmap</span><span class="p">(</span><span class="n">map_grid</span><span class="p">,</span><span class="w"> </span><span class="n">zoom</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">5</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w"> </span><span class="n">ggmap</span><span class="p">()</span><span class="o">+</span><span class="w">
  </span><span class="n">stat_MST</span><span class="p">(</span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">out</span><span class="p">,</span><span class="w">
           </span><span class="n">aes</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lon</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lat</span><span class="p">,</span><span class="w"> </span><span class="n">from</span><span class="o">=</span><span class="n">from</span><span class="p">,</span><span class="w"> </span><span class="n">to</span><span class="o">=</span><span class="n">to</span><span class="p">),</span><span class="w"> 
           </span><span class="n">colour</span><span class="o">=</span><span class="s2">"red"</span><span class="p">,</span><span class="w"> </span><span class="n">linetype</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">)</span><span class="o">+</span><span class="w">
  </span><span class="n">geom_point</span><span class="p">(</span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">out</span><span class="p">,</span><span class="w"> </span><span class="n">aes</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lon</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">lat</span><span class="p">),</span><span class="w"> </span><span class="n">size</span><span class="o">=</span><span class="m">3</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error in `get_stamenmap()`:
## ! Stamen map tiles are now hosted by Stadia Maps, use `get_stadiamap()`.</code></pre></figure> <p>Once you have the information about the minimum route, it is easy to see that you will have to install gas distribution hubs in cities that will have more than two incoming or outgoing links, such as Assuncion in Paraguay. Based on that information or other criteria such as connectivity or even by cutting the largest edge, you can also define or separate regions of operations. What I mean by this is that you can also use Minimum Spanning Trees in clustering problems. Nonetheless, let’s save that topic for another post.</p> <p>Below, I will present other things you can do with ‘emstreeR’.</p> <p>‘emstreeR’ provides an S3 method for the {base} function <code class="language-plaintext highlighter-rouge">plot()</code>. It is easy to make simple 2D plots with that.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## artifical data for 2D plots:</span><span class="w">
</span><span class="n">set.seed</span><span class="p">(</span><span class="m">1984</span><span class="p">)</span><span class="w">
</span><span class="n">n</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="m">15</span><span class="w">
</span><span class="n">c1</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">data.frame</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="m">-0.2</span><span class="p">,</span><span class="w"> </span><span class="n">sd</span><span class="o">=</span><span class="m">0.2</span><span class="p">),</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="m">-2</span><span class="p">,</span><span class="n">sd</span><span class="o">=</span><span class="m">0.2</span><span class="p">))</span><span class="w">
</span><span class="n">c2</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">data.frame</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="m">-1.1</span><span class="p">,</span><span class="w"> </span><span class="n">sd</span><span class="o">=</span><span class="m">0.15</span><span class="p">),</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="m">-2</span><span class="p">,</span><span class="n">sd</span><span class="o">=</span><span class="m">0.3</span><span class="p">))</span><span class="w"> 
</span><span class="n">d</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">rbind</span><span class="p">(</span><span class="n">c1</span><span class="p">,</span><span class="w"> </span><span class="n">c2</span><span class="p">)</span><span class="w">
</span><span class="n">d</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">as.data.frame</span><span class="p">(</span><span class="n">d</span><span class="p">)</span><span class="w">
  
</span><span class="c1">## MST:</span><span class="w">
</span><span class="c1">#library(emstreeR)</span><span class="w">
</span><span class="n">out</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">ComputeMST</span><span class="p">(</span><span class="n">d</span><span class="p">,</span><span class="w"> </span><span class="n">verbose</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="kc">FALSE</span><span class="p">)</span><span class="w">  </span></code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## simple 2D plot:</span><span class="w">
</span><span class="n">plot</span><span class="p">(</span><span class="n">out</span><span class="p">,</span><span class="w"> </span><span class="n">col.pts</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"red"</span><span class="p">,</span><span class="w"> </span><span class="n">col.segts</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"blue"</span><span class="p">)</span></code></pre></figure> <p><img src="https://allanvc.github.io/assets/img/posts/2018-12-10-new-package-emstreer/unnamed-chunk-9-1.png" alt="plot of chunk unnamed-chunk-9"/></p> <p>The <code class="language-plaintext highlighter-rouge">stat_MST()</code> extension also makes it easy plotting 2D plots, but using {ggplot2} as we showed before.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## 2D plot with ggplot2:</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">ggplot2</span><span class="p">)</span><span class="w">
</span><span class="n">ggplot</span><span class="p">(</span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">out</span><span class="p">,</span><span class="w"> </span><span class="n">aes</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">x</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">y</span><span class="p">,</span><span class="w"> </span><span class="n">from</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">from</span><span class="p">,</span><span class="w"> </span><span class="n">to</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">to</span><span class="p">))</span><span class="o">+</span><span class="w"> 
  </span><span class="n">geom_point</span><span class="p">()</span><span class="o">+</span><span class="w"> 
  </span><span class="n">stat_MST</span><span class="p">(</span><span class="n">colour</span><span class="o">=</span><span class="s2">"red"</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Warning: The following aesthetics were dropped during statistical transformation: from
## and to.
## ℹ This can happen when ggplot fails to infer the correct grouping structure in
##   the data.
## ℹ Did you forget to specify a `group` aesthetic or to convert a numerical
##   variable into a factor?</code></pre></figure> <p><img src="https://allanvc.github.io/assets/img/posts/2018-12-10-new-package-emstreer/unnamed-chunk-10-1.png" alt="plot of chunk unnamed-chunk-10"/></p> <p>If you want something fancier, you can use the <code class="language-plaintext highlighter-rouge">geom=curve</code> argument:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## 2D plot with ggplot2:</span><span class="w">
</span><span class="c1">#library(ggplot2)</span><span class="w">
</span><span class="n">ggplot</span><span class="p">(</span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">out</span><span class="p">,</span><span class="w"> </span><span class="n">aes</span><span class="p">(</span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">x</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">y</span><span class="p">,</span><span class="w"> </span><span class="n">from</span><span class="o">=</span><span class="n">from</span><span class="p">,</span><span class="w"> </span><span class="n">to</span><span class="o">=</span><span class="n">to</span><span class="p">))</span><span class="o">+</span><span class="w"> 
  </span><span class="n">geom_point</span><span class="p">()</span><span class="o">+</span><span class="w"> 
  </span><span class="n">stat_MST</span><span class="p">(</span><span class="n">geom</span><span class="o">=</span><span class="s2">"curve"</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Warning: The following aesthetics were dropped during statistical transformation: from
## and to.
## ℹ This can happen when ggplot fails to infer the correct grouping structure in
##   the data.
## ℹ Did you forget to specify a `group` aesthetic or to convert a numerical
##   variable into a factor?</code></pre></figure> <p><img src="https://allanvc.github.io/assets/img/posts/2018-12-10-new-package-emstreer/unnamed-chunk-11-1.png" alt="plot of chunk unnamed-chunk-11"/></p> <p>You can also make 3D MST plots with <code class="language-plaintext highlighter-rouge">emstreeR</code>. It provides a wrapper for plotting 3D scatter plots, using the {scatterplot3d} package.</p> <p>Let’s create 3D artificial data and compute the MST.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## artificial data for 3D plots:</span><span class="w">
</span><span class="n">n</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">99</span><span class="w">
</span><span class="n">set.seed</span><span class="p">(</span><span class="m">1984</span><span class="p">)</span><span class="w">
</span><span class="n">d1</span><span class="o">&lt;-</span><span class="n">matrix</span><span class="p">(</span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="n">mean</span><span class="o">=</span><span class="m">-2</span><span class="p">,</span><span class="n">sd</span><span class="o">=</span><span class="m">.5</span><span class="p">),</span><span class="w"> </span><span class="n">n</span><span class="o">/</span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="m">3</span><span class="p">)</span><span class="w"> </span><span class="c1"># 3d</span><span class="w">
</span><span class="n">d2</span><span class="o">&lt;-</span><span class="n">matrix</span><span class="p">(</span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="n">mean</span><span class="o">=</span><span class="m">0</span><span class="p">,</span><span class="n">sd</span><span class="o">=</span><span class="m">.3</span><span class="p">),</span><span class="w"> </span><span class="n">n</span><span class="o">/</span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="m">3</span><span class="p">)</span><span class="w">
</span><span class="n">d3</span><span class="o">&lt;-</span><span class="n">matrix</span><span class="p">(</span><span class="n">rnorm</span><span class="p">(</span><span class="n">n</span><span class="p">,</span><span class="n">mean</span><span class="o">=</span><span class="m">3</span><span class="p">,</span><span class="n">sd</span><span class="o">=</span><span class="m">.4</span><span class="p">),</span><span class="w"> </span><span class="n">n</span><span class="o">/</span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="m">3</span><span class="p">)</span><span class="w">
</span><span class="n">d</span><span class="o">&lt;-</span><span class="n">rbind</span><span class="p">(</span><span class="n">d1</span><span class="p">,</span><span class="n">d2</span><span class="p">,</span><span class="n">d3</span><span class="p">)</span><span class="w"> </span><span class="c1"># just to show a matrix input</span><span class="w">
  
</span><span class="c1">## MST:</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">emstreeR</span><span class="p">)</span><span class="w">
</span><span class="n">out</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">ComputeMST</span><span class="p">(</span><span class="n">d</span><span class="p">,</span><span class="w"> </span><span class="n">verbose</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="kc">FALSE</span><span class="p">)</span></code></pre></figure> <p>We can do a simple 3D plot using the function <code class="language-plaintext highlighter-rouge">plotMST3D()</code>.</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1">## simple 3D plot:</span><span class="w">
</span><span class="n">plotMST3D</span><span class="p">(</span><span class="n">out</span><span class="p">,</span><span class="w"> </span><span class="n">xlab</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"xaxis"</span><span class="p">,</span><span class="w"> </span><span class="n">main</span><span class="o">=</span><span class="s2">"A simple MST 3D plot"</span><span class="p">)</span></code></pre></figure> <p><img src="https://allanvc.github.io/assets/img/posts/2018-12-10-new-package-emstreer/unnamed-chunk-13-1.png" alt="plot of chunk unnamed-chunk-13"/></p> <p>But, again, if you like fancier plots, we can also make an interactive 3D MST plot using {plotly}:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># some adjustments needed</span><span class="w">
</span><span class="n">ord_id</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">Reduce</span><span class="p">(</span><span class="n">rbind</span><span class="p">,</span><span class="w"> </span><span class="n">rbind</span><span class="p">(</span><span class="n">t</span><span class="p">(</span><span class="n">out</span><span class="p">[,</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="s2">"from"</span><span class="p">,</span><span class="w"> </span><span class="s2">"to"</span><span class="p">)]),</span><span class="w"> </span><span class="kc">NA</span><span class="p">))</span><span class="w">
</span><span class="n">ord_data</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">out</span><span class="p">[</span><span class="n">ord_id</span><span class="p">,</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="s2">"V1"</span><span class="p">,</span><span class="w"> </span><span class="s2">"V2"</span><span class="p">,</span><span class="w"> </span><span class="s2">"V3"</span><span class="p">)]</span><span class="w">

</span><span class="n">library</span><span class="p">(</span><span class="n">dplyr</span><span class="p">)</span><span class="w"> </span><span class="c1"># we will use pipes</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">plotly</span><span class="p">)</span><span class="w">

</span><span class="n">plot_ly</span><span class="p">(</span><span class="n">showlegend</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nb">T</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">add_markers</span><span class="p">(</span><span class="n">data</span><span class="o">=</span><span class="n">ord_data</span><span class="p">,</span><span class="w"> </span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V1</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V2</span><span class="p">,</span><span class="w"> </span><span class="n">z</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V3</span><span class="p">,</span><span class="w">
              </span><span class="n">marker</span><span class="o">=</span><span class="nf">list</span><span class="p">(</span><span class="n">opacity</span><span class="o">=</span><span class="m">0.5</span><span class="p">,</span><span class="w"> </span><span class="n">size</span><span class="o">=</span><span class="m">2.5</span><span class="p">),</span><span class="w"> </span><span class="n">name</span><span class="o">=</span><span class="s2">"points"</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">add_paths</span><span class="p">(</span><span class="n">data</span><span class="o">=</span><span class="n">ord_data</span><span class="p">,</span><span class="w"> </span><span class="n">x</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V1</span><span class="p">,</span><span class="w"> </span><span class="n">y</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V2</span><span class="p">,</span><span class="w"> </span><span class="n">z</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="o">~</span><span class="n">V3</span><span class="p">,</span><span class="w">
            </span><span class="n">color</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">I</span><span class="p">(</span><span class="s2">"red"</span><span class="p">),</span><span class="w"> </span><span class="n">name</span><span class="o">=</span><span class="s2">"edges"</span><span class="p">)</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## Error in `loadNamespace()`:
## ! there is no package called 'webshot'</code></pre></figure> <p>That’s all!</p> <ul> <li>CRAN version: https://cran.r-project.org/package=emstreeR</li> <li>Dev version: https://github.com/allanvc/emstreeR</li> </ul> <hr/>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="emstreeR"/> <category term="Minimum Spanning Trees"/> <category term="mlpack"/> <summary type="html"><![CDATA[Announcing the new ‘emstreeR’ package (2020’s {ggmap} update)]]></summary> </entry> <entry> <title type="html">Scraping Google News with ‘rvest’</title> <link href="https://allanvc.github.io/blog/2018/google-news-scraping/" rel="alternate" type="text/html" title="Scraping Google News with ‘rvest’"/> <published>2018-08-21T00:00:00+00:00</published> <updated>2018-08-21T00:00:00+00:00</updated> <id>https://allanvc.github.io/blog/2018/google-news-scraping</id> <content type="html" xml:base="https://allanvc.github.io/blog/2018/google-news-scraping/"><![CDATA[<h2 id="scraping-google-news-with-rvest-2020s-update">Scraping Google News with <code class="language-plaintext highlighter-rouge">rvest</code> (2020’s update)</h2> <p>Updated on 2026-08-25. This is an enhanced and substantially different version of the original article published in R-Bloggers in 2018.</p> <hr/> <p>This is an example of how to scrape Google News website with the <code class="language-plaintext highlighter-rouge">rvest</code> package.</p> <p>First off, you should take a look at the Google News website <a href="https://news.google.com/" target="_blank">HERE</a>, which I reproduce below:</p> <p><img src="https://allanvc.github.io/assets/img/posts/2018-08-21-google-news-scraping/img/screenshot1.png" alt="" width="100%"/></p> <p>You may notice, on the right side of the page, that we are using Google Chrome <strong>dev-tools</strong>. This is necessary in order to identify the <em>html nodes</em> we need. You can access this tool by hitting the <strong>F12</strong> key. The html nodes are passed as arguments to the <code class="language-plaintext highlighter-rouge">rvest</code> functions.</p> <p>Basically, the idea is to extract the communication vehicle (vehicle), the time elapsed since the news was published (time), and the main headline (headline).</p> <p>The code and comments are presented below:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># loading the packages:</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">dplyr</span><span class="p">)</span><span class="w"> </span><span class="c1"># for pipes and the data_frame function</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">rvest</span><span class="p">)</span><span class="w"> </span><span class="c1"># webscraping</span><span class="w">
</span><span class="n">library</span><span class="p">(</span><span class="n">stringr</span><span class="p">)</span><span class="w"> </span><span class="c1"># to deal with strings and to clean up our data</span></code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># extracting the whole website</span><span class="w">
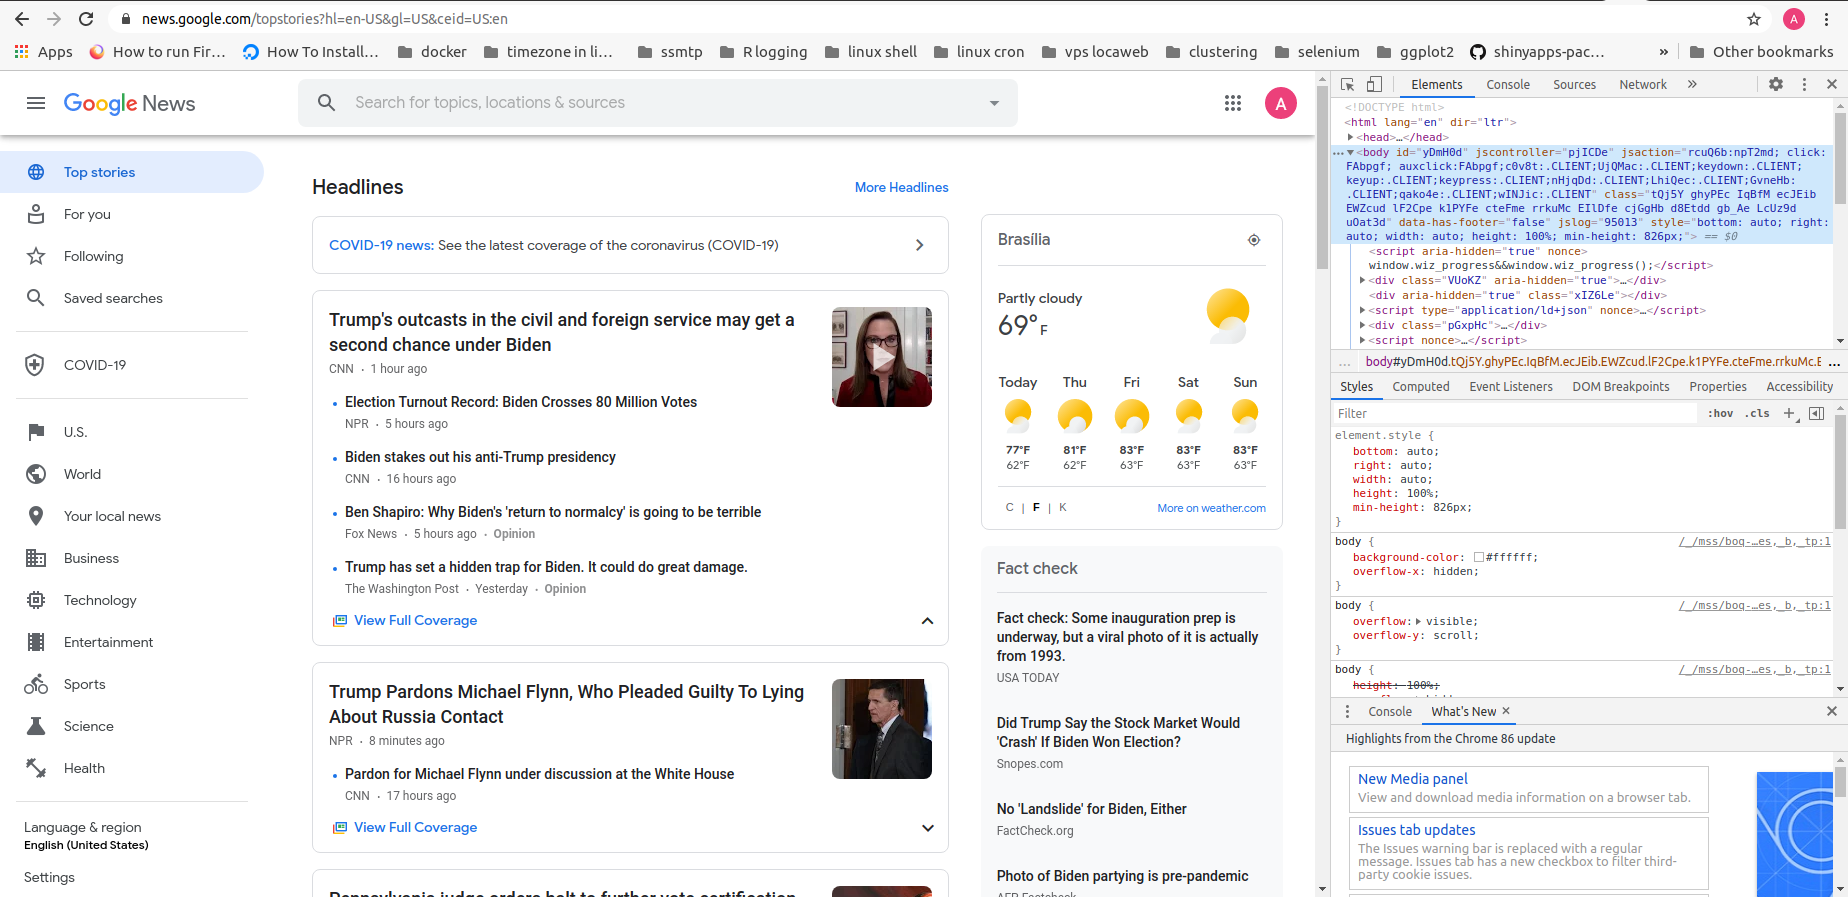
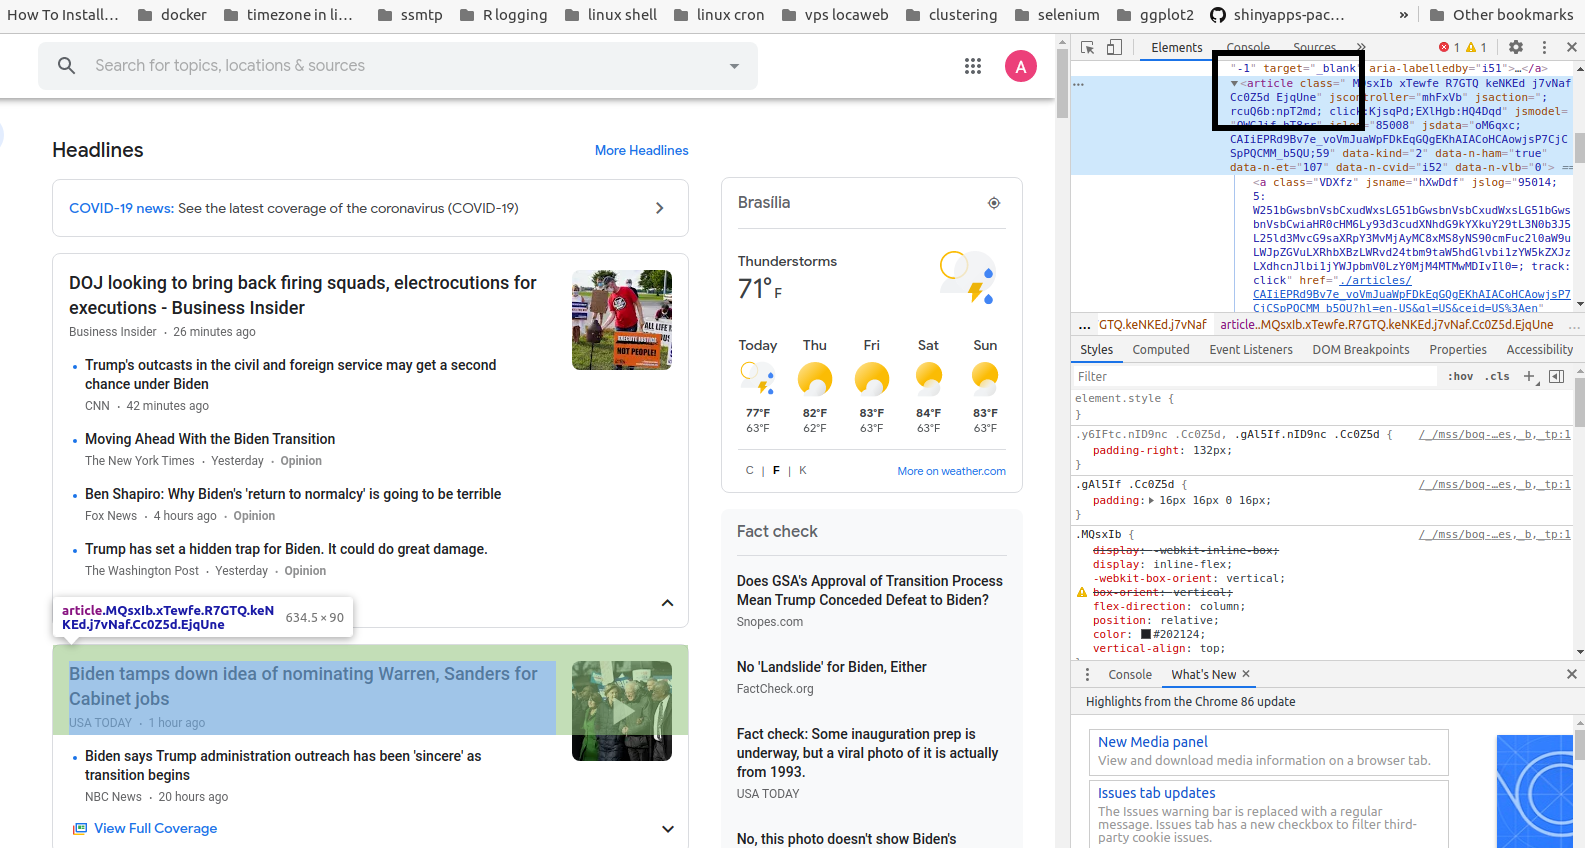
</span><span class="n">google</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">read_html</span><span class="p">(</span><span class="s2">"https://news.google.com/"</span><span class="p">)</span></code></pre></figure> <p>As we can see, the Google News website is divided in rectangular chunks of headlines and other info. Therefore, our strategy is to first scrape the whole chunks, and then, for each chunk scrape the information of interest: vehicle, time, and headlines.</p> <p>We start scraping the whole chunks of articles. By using the “inspect” tool of our browser, we can see that the <em>“article”</em> \HTML node is the one that identifies each chunk.</p> <p><img src="https://allanvc.github.io/assets/img/posts/2018-08-21-google-news-scraping/img/screenshot2.png" alt="" width="100%"/></p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># extracting the headlines</span><span class="w">
</span><span class="c1"># and using stringr for cleaning</span><span class="w">
</span><span class="n">article_all</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">google</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w"> </span><span class="n">html_nodes</span><span class="p">(</span><span class="s2">"article"</span><span class="p">)</span><span class="w">

</span><span class="n">article_all</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## {xml_nodeset (0)}</code></pre></figure> <p>Having the whole chunks, now we can separately scrape the information of interest:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">times</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">article_all</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_node</span><span class="p">(</span><span class="s2">"time"</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_text</span><span class="p">()</span><span class="w">

</span><span class="n">vehicles</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">article_all</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_nodes</span><span class="p">(</span><span class="s2">"a.wEwyrc.AVN2gc.uQIVzc.Sksgp"</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_text</span><span class="p">()</span><span class="w">

</span><span class="n">headlines</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">article_all</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_nodes</span><span class="p">(</span><span class="s2">"a.DY5T1d"</span><span class="p">)</span><span class="w"> </span><span class="o">%&gt;%</span><span class="w">
  </span><span class="n">html_text</span><span class="p">()</span></code></pre></figure> <p>Let’s take a look at these vectors:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="c1"># take a look at the first ten</span><span class="w">
</span><span class="n">headlines</span><span class="p">[</span><span class="m">1</span><span class="o">:</span><span class="m">10</span><span class="p">]</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">##  [1] NA NA NA NA NA NA NA NA NA NA</code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">vehicles</span><span class="p">[</span><span class="m">1</span><span class="o">:</span><span class="m">10</span><span class="p">]</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">##  [1] NA NA NA NA NA NA NA NA NA NA</code></pre></figure> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">times</span><span class="p">[</span><span class="m">1</span><span class="o">:</span><span class="m">10</span><span class="p">]</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">##  [1] NA NA NA NA NA NA NA NA NA NA</code></pre></figure> <p>It seems all good!</p> <p>Then, we can proceed to generate our final <code class="language-plaintext highlighter-rouge">tibble</code>:</p> <figure class="highlight"><pre><code class="language-r" data-lang="r"><span class="n">tb_news</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">tibble</span><span class="p">(</span><span class="n">headlines</span><span class="p">,</span><span class="w"> </span><span class="n">vehicles</span><span class="p">,</span><span class="w"> </span><span class="n">times</span><span class="p">)</span><span class="w">

</span><span class="n">tb_news</span></code></pre></figure> <figure class="highlight"><pre><code class="language-text" data-lang="text">## # A tibble: 0 × 3
## # ℹ 3 variables: headlines &lt;chr&gt;, vehicles &lt;chr&gt;, times &lt;chr&gt;</code></pre></figure> <p>That’s all!</p>]]></content> <author> <name>Allan Quadros</name> </author> <category term="R"/> <category term="rvest"/> <category term="web scraping"/> <category term="GoogleNews"/> <summary type="html"><![CDATA[Scraping Google News with rvest (2020’s update)]]></summary> </entry> </feed>